E · Training Architecture
Attention · cách token lấy thông tin từ ngữ cảnh
Theo dõi Query, Key và Value qua một ví dụ nhỏ để hiểu cách attention gom ngữ cảnh, chặn tương lai và tổ chức bộ nhớ đệm khi sinh tiếp.
1Định nghĩa
Attention là phép tính cập nhật vector biểu diễn một token bằng cách lấy tổng có trọng số các vector nội dung ở những vị trí được phép đọc. Token là đơn vị văn bản mô hình xử lý, có thể là một phần từ; vector là danh sách số biểu diễn token tại một lớp. Trong Transformer, attention cho vị trí hiện tại lấy thông tin từ ngữ cảnh thay vì chỉ xử lý vector riêng của nó. Đầu ra vẫn là vector số, chưa phải từ được sinh ra.
Từ mỗi vector đầu vào, mô hình tạo Query (Q, dùng để tra cứu), Key (K, dùng để đối chiếu) và Value (V, nội dung đem gom). Q đối chiếu với các K để tạo điểm; mặt nạ nhân quả chặn vị trí tương lai trong mô hình sinh từng token; softmax đổi điểm thành trọng số để cộng các V. Một head là một nhánh làm phép tính này. Khi sinh tiếp, KV cache giữ K/V cũ để dùng lại; mô hình có thể thiết kế các Q head có K/V riêng hoặc dùng chung.
Ví dụ đời thường: Khi nấu ăn, bạn muốn kiểm tra lượng muối cho món hiện tại. Nhu cầu tra cứu giống Q, nhãn trên các trang sổ công thức giống K, còn nội dung hướng dẫn giống V. Bạn đối chiếu nhãn rồi kết hợp nội dung của những trang phù hợp; không lấy nhãn làm nguyên liệu. So sánh này giúp nhớ Q/K dùng để tìm nguồn, V mang nội dung; trong mô hình mọi bước là phép tính trên số, không có người hiểu công thức hay bắt buộc chỉ chọn một trang.
2Luồng
Cách đọc hình: bắt đầu ở 1A dưới cột 1, đi lên 1B để tạo Q/K/V. Ở cột 2, theo 2B → 2C → 2D → 2E; 2A cung cấp quy tắc chặn tương lai cho 2C. Cột 3 cấp K/V cho cột 2, không phải bước chỉ chạy sau attention. Sau đó theo đầu ra sang 4A–4C. MHA/GQA/MQA/MLA là các lựa chọn tổ chức attention; Dense/MoE là các lựa chọn xử lý từng vị trí, không phải các bước nối tiếp. Bài này giải thích cơ chế bằng một head; lab ở bài Transformer dùng hai head MHA và nhánh Dense.
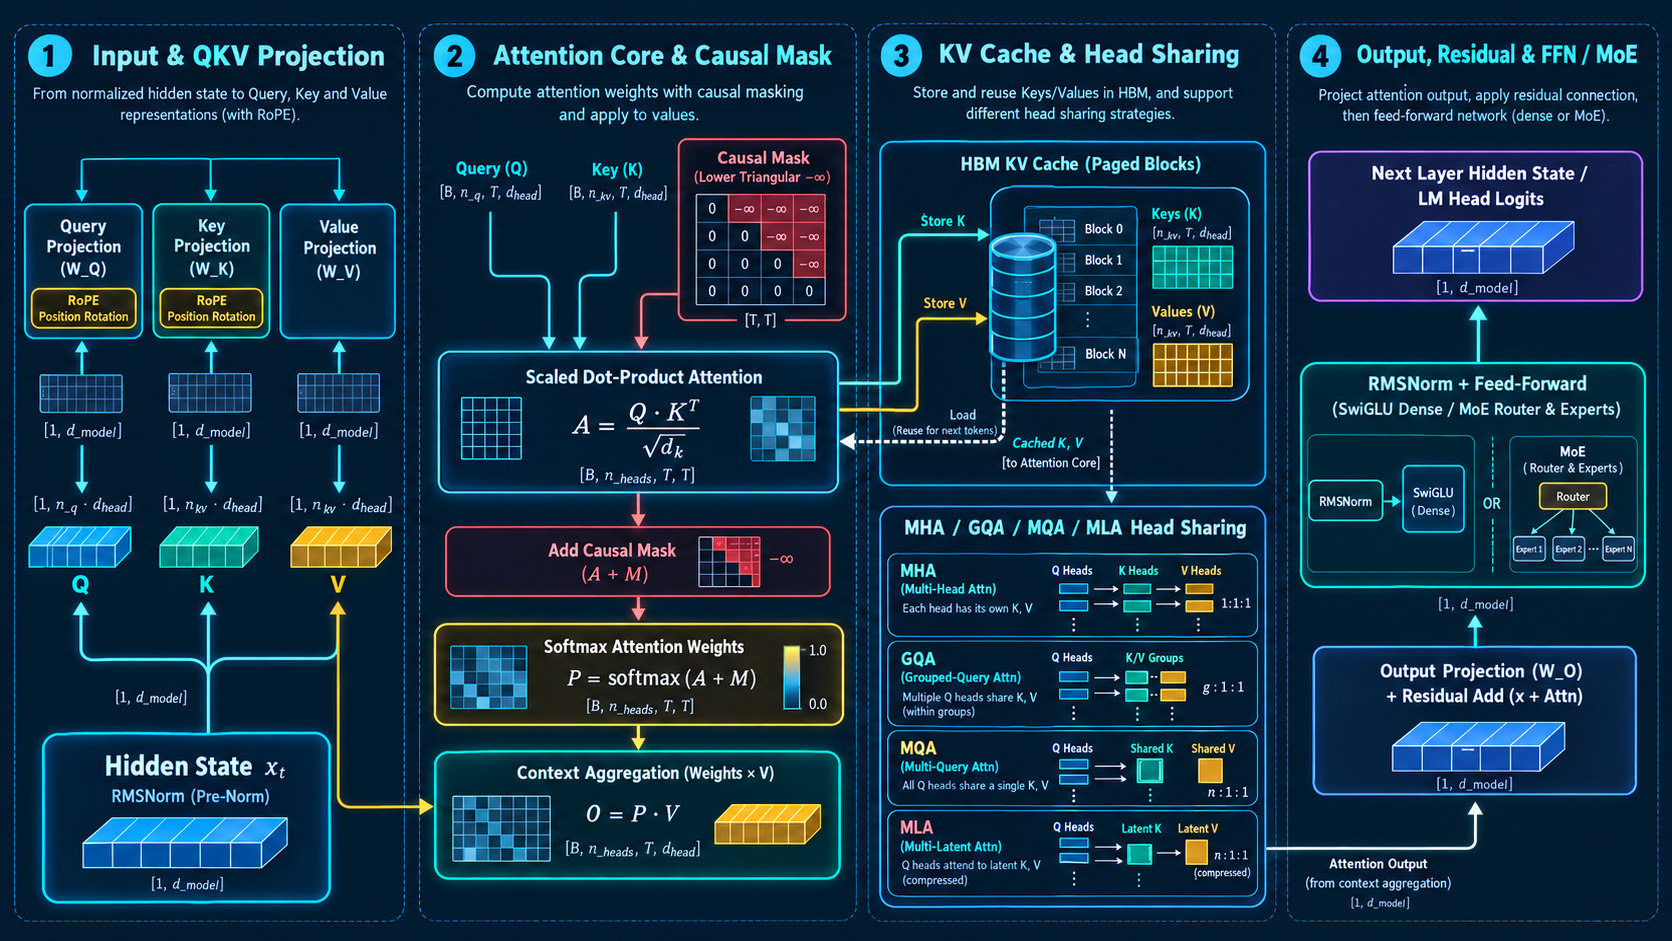
x_t: [1, d_model] → x̂_t = RMSNorm(x_t) Hidden State x_t & RMSNorm (Pre-Norm)
Chuẩn hóa biên độ vector ẩn đầu vào trước khi tách nhánh chiếu Q, K, V.
Bắt đầu từ vector của một vị trí: ở lớp đầu nó đến từ embedding; ở lớp sau nó đến từ lớp trước. RMSNorm điều chỉnh biên độ trước khi tạo Q/K/V. Hãy giữ riêng vector gốc x_t: bước 4A còn cần nó để cộng residual. Trong lab, so hàng đầu trước và sau RMSNorm; số chiều không đổi, chỉ giá trị đổi. Đây là chuẩn bị dữ liệu, chưa có bước trộn thông tin giữa token.
3Giải pháp
Mục tiêu học: bạn chỉ cần biết danh sách số và phép cộng, nhân; không cần học máy từ trước. Sau bài, hãy tự giải thích được attention nhận gì, vì sao phải chặn tương lai, cách đọc một hàng trọng số và vì sao cache không loại bỏ việc đọc ngữ cảnh. Bắt đầu từ ví dụ một head bên dưới trước khi so sánh các biến thể nhiều head. Muốn thực hành toàn bộ lớp, mở bài Transformer và lab sau khi hoàn tất ví dụ.
1A–1B · Chuẩn bị đầu vào. Mỗi vị trí có một vector; cả chuỗi thành bảng có hàng là vị trí, cột là thành phần vector. Trên hình, RMSNorm (Root Mean Square Normalization, chuẩn hóa theo căn trung bình bình phương) điều chỉnh biên độ vector trước khi nhân với ba bảng trọng số đã học để tạo Q/K/V; phép nhân đó gọi là phép chiếu. RoPE, Rotary Position Embedding, xoay Q/K theo vị trí để phép đối chiếu phản ánh khoảng cách tương đối. Các tên này mô tả chuẩn bị dữ liệu; chưa phải bước gom nội dung từ token khác.
2B · Tạo điểm liên quan. Với một Q, nhân các phần tử cùng chỉ số với một K rồi cộng lại: đó là tích vô hướng. Làm với từng K tạo một hàng điểm. Chia các điểm cho căn bậc hai của số thành phần trong vector Q của một head, ký hiệu d, để kiểm soát độ lớn khi d tăng. Công thức trên hình Q × Kᵀ / √d chỉ là cách tính đồng thời nhiều hàng; Kᵀ nghĩa là đổi hàng và cột của bảng K để nhân được. Một điểm lớn chỉ nói cặp Q/K được ưu tiên hơn trong phép đối chiếu này, không tự chứng minh quan hệ ngôn ngữ đúng.
2A–2D · Chặn trước rồi chuẩn hóa. Với mô hình dự đoán token kế tiếp, hàng ở vị trí i chỉ đọc cột j khi j ≤ i, kể cả chính nó. Đặt điểm các ô tương lai thành âm vô cực, không phải 0: softmax vẫn cho điểm 0 một trọng số dương. Softmax lấy hàm mũ của từng điểm hợp lệ rồi chia cho tổng trên hàng, tạo trọng số không âm có tổng bằng 1. Nhờ đó có thể xử lý nhiều vị trí song song mà mỗi vị trí vẫn không nhìn trộm phần sau.
2E–4A · Gom nội dung. Nhân mỗi trọng số với V ở cùng cột rồi cộng các vector kết quả. Đầu ra của một head tại một vị trí có cùng số thành phần với V của head đó. Khi có nhiều head, ghép các vector ngữ cảnh tại cùng vị trí, chiếu qua bảng trọng số W_O rồi cộng vào vector gốc; phép cộng giữ thông tin cũ này gọi là residual. Nhánh FFN, Feed-Forward Network, mạng truyền thẳng, sau đó biến đổi riêng từng vị trí. Chỉ cuối toàn mạng, LM head, phép chiếu đầu ra lên bảng từ vựng, mới tạo logits, tức điểm cho các token ứng viên; trọng số attention không phải xác suất chọn token tiếp theo.
3B · Phân biệt các lựa chọn tổ chức head. MHA, Multi-Head Attention cho mỗi Q head một bộ K/V riêng. GQA, Grouped-Query Attention cho nhiều Q head trong một nhóm đọc chung một bộ K/V; các Q vẫn khác nhau nên trọng số có thể khác. MQA, Multi-Query Attention cho tất cả Q head dùng chung một bộ K/V. Với cùng số lớp, token, chiều vector và kiểu số, bớt bộ K/V làm giảm lượng dữ liệu cache chuẩn phải lưu; đó chưa phải bằng chứng chất lượng hay tốc độ tốt hơn.
MLA, Multi-head Latent Attention, là lựa chọn nén: lưu một biểu diễn trung gian nhỏ của nội dung K/V, cùng phần vị trí mà kiến trúc yêu cầu, thay vì lưu đủ mọi K/V head như trên. Không thể chỉ thay số head trong công thức GQA để tính cache MLA. Sau khi hiểu ví dụ cache chuẩn, đọc bài MLA để xem dữ liệu nào được nén và dữ liệu nào vẫn phải giữ. Các hàng MHA/GQA/MQA/MLA trên hình là phương án thay thế, không phải bốn bước phải chạy.
3A · Dùng lại dữ liệu theo thời gian. Prefill là lượt xử lý chuỗi đầu vào ban đầu; decode là lượt xử lý token mới để dự đoán token sau nữa. Trong mô hình causal của bài, cùng tham số và cùng vị trí thì K/V của token cũ không đổi khi nối thêm token. Cache giữ chúng lại; Q mới vẫn phải đối chiếu với K cũ và K mới được phép đọc. Chỉ chọn một mã token chưa làm cache dài thêm: phải đưa token ấy qua mạng để tạo rồi nối K/V của nó. Tổ chức head trả lời ai dùng bộ K/V nào; cache trả lời kết quả của token cũ nào được dùng lại.
Ước lượng trước khi chạy. Với một chuỗi, cache K/V chuẩn chưa nén, mọi lớp cùng cấu hình và K/V cùng chiều d, dung lượng phần dữ liệu là 2 × L × T × Hkv × d × b byte. Số 2 đếm cả K và V; L là số lớp attention, T là số token đã xử lý, Hkv là số bộ K/V trong mỗi lớp, d là số thành phần mỗi vector của một head, b là byte mỗi phần tử. Ví dụ bên dưới thay từng số để bạn tự kiểm tra. Chưa tính vùng cấp phát dư, thông tin quản lý, chia hay nhân bản dữ liệu trên nhiều thiết bị; không áp nguyên công thức cho MLA hoặc lớp lưu trạng thái kiểu khác.
Khi triển khai mô hình có sẵn, đọc checkpoint (bản lưu tham số) để biết cấu trúc Q/K/V, vị trí và cách lưu cache mà phần mềm phải hỗ trợ. Thay kernel, tức hàm tính toán, bằng bản tương đương có thể đổi cách thực thi mà giữ kết quả trong sai số. Đổi MHA thành GQA/MQA/MLA là đổi cấu trúc, cần mô hình được huấn luyện hoặc chuyển đổi thích hợp; không chỉ bật tùy chọn giảm cache cho checkpoint bất kỳ.
4Profiling
- Kiểm tra phép tính và mặt nạ trước khi đo tốc độ
Dùng ví dụ một head bên dưới làm mốc: hàng đầu phải là [1, 0, 0], các ô tương lai bằng 0 và tổng mỗi hàng gần 1. Với kernel mới, so đầu ra vector với bản tính trực tiếp trên cùng Q/K/V và cùng mask; ghi kiểu số cùng ngưỡng sai số đã chọn. Khi thêm padding, tức vị trí đệm để các chuỗi dài bằng nhau, phải chặn cả các vị trí đệm; bài này chỉ tính ba token thật, chưa kiểm thử padding.
- So đường dùng cache với đường tính lại toàn chuỗi
Giữ cùng tham số, chuỗi token và vị trí; chạy một đường chỉ xử lý token mới với cache, đường kia tính lại toàn chuỗi. So đầu ra của token mới hoặc hàng logits cuối, đồng thời kiểm tra K/V cũ không bị đổi. Lab Transformer liên quan dùng ngưỡng sai khác tuyệt đối tối đa 1e-9 cho cấu hình của nó; không lấy ngưỡng này làm chuẩn mặc định cho mọi kiểu số hoặc thiết bị. Kết quả khớp chỉ xác nhận các trường hợp đã thử, chưa chứng minh chất lượng ngôn ngữ.
- Đối chiếu dung lượng dự tính với bộ nhớ thực
Ghi L, T, Hkv, d và b, tính riêng phần K/V rồi đo lượng cấp phát thực. Batch nghĩa là nhóm chuỗi xử lý cùng lượt; nếu các chuỗi dài khác nhau, cộng phần cache của từng chuỗi thay vì nhân với một chiều dài tùy ý. Chênh lệch có thể đến từ vùng dự phòng, khối chưa dùng hết hoặc dữ liệu nhân bản; phân biệt bộ nhớ đã cấp phát với dữ liệu K/V hữu ích.
- Đo riêng prefill và decode với điều kiện cố định
Sau khi kiểm tra đúng, giữ cố định mô hình, thiết bị, kiểu số, độ dài chuỗi, batch và cách đo. Chạy khởi động trước, hoàn tất phép tính trên thiết bị trước khi đọc đồng hồ rồi lặp nhiều lần; so thời gian với mốc cũ và ghi độ dao động. Decode có thể bị giới hạn bởi băng thông, tức lượng dữ liệu đọc được mỗi giây, nhưng còn chi phí tính và điều phối. Ít bộ K/V hơn không bảo đảm giảm thời gian theo cùng tỷ lệ. Ví dụ số của bài không phải benchmark và không công bố mức tăng tốc.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Bước 1 · Dự đoán trước khi tính một head
Dùng dữ liệu số tự chọn để học cơ chế, không phải số lấy từ checkpoint hay output lab. Có ba vị trí 0, 1, 2; mỗi Q, K, V là vector hai số, d = 2. Cả ba Q đều là [1, 0]. Các K lần lượt là [0, 1], [1, 0], [0, -1]; các V là [2, 0], [0, 2], [2, 2]. Mỗi bảng Q/K/V có ba hàng vị trí và hai cột thành phần; ta bắt đầu sau phép chiếu và vị trí, không thực hiện RMSNorm hay RoPE ở ví dụ này. Trước khi tính, hãy dự đoán hàng 0 được đọc V nào và vì sao hàng 2 có thể đọc nhiều hơn.
Bước 2 · Từ Q/K đến điểm đã chặn tương lai
Vì Q = [1, 0], tích vô hướng với ba K là [0, 1, 0]. Chia từng điểm cho √2 được xấp xỉ [0, 0.707107, 0]. Ba Q giống nhau nên trước mask cả ba hàng giống nhau. Sau causal mask, hàng 0 là [0, -∞, -∞], hàng 1 là [0, 0.707107, -∞], hàng 2 giữ [0, 0.707107, 0]. Tự kiểm tra: vì sao hàng 0 không đọc vị trí 1 dù điểm ở đó cao nhất? Đáp án: quyền đọc do mask quyết định trước softmax, không do điểm lớn hay nhỏ.
Bước 3 · Đọc trọng số rồi gom V
Softmax hàng 2 lấy các hàm mũ xấp xỉ [1, 2.028115, 1], chia cho tổng 4.028115, cho trọng số [0.248255, 0.503490, 0.248255]. Cột 1 nhận khoảng một nửa trọng số; đây là vị trí đầu vào số 1, không phải mã token sẽ được sinh. Đầu ra là 0.248255 × [2, 0] + 0.503490 × [0, 2] + 0.248255 × [2, 2], xấp xỉ [0.993020, 1.503490]. Hàng 0 có trọng số [1, 0, 0] và trả đúng V0 = [2, 0]. Hàng 1 có [0.330238, 0.669762, 0] và cho [0.660477, 1.339523]. Các số làm tròn đến sáu chữ số thập phân; hãy tự cộng trọng số và tính lại từng thành phần. Kết quả là vector ngữ cảnh, không phải xác suất từ vựng hay bằng chứng hiểu ngôn ngữ.
Tự kiểm tra · Thay Value khác thay Key ở đâu?
Giữ Q/K như trên, chỉ đổi V2 từ [2, 2] thành [4, 2]. Hãy dự đoán trọng số nào đổi và đầu ra hàng nào đổi trước khi tính lại. Đáp án: không trọng số nào đổi vì điểm chỉ phụ thuộc Q/K và mask. Hai hàng đầu không đổi vì không được đọc vị trí 2; thành phần đầu của output hàng 2 tăng 2 × 0.248255, thành xấp xỉ [1.489530, 1.503490]. Nếu đổi K2 thay vì V2, điểm và trọng số hàng 2 có thể đổi. Bài tập cố ý đổi bảng V riêng; đổi mã token trong mô hình thật thường làm đổi cả Q/K/V, không phải chỉ V.
Tự kiểm tra · Tính cache của MHA, GQA và MQA
Giả sử hai lớp, đã xử lý ba token, bốn Q head, mỗi vector K/V có hai số và mỗi số dùng hai byte. MHA có bốn bộ K/V: 2 × 2 × 3 × 4 × 2 × 2 = 192 byte dữ liệu cache. GQA với hai bộ K/V cần 96 byte; MQA với một bộ cần 48 byte. Trước khi xem đáp án, hãy tính GQA sau khi xử lý token thứ tư. Đáp án: 128 byte, tăng 32 byte cho K và V mới ở cả hai lớp; chọn token mà chưa xử lý nó thì vẫn 96 byte. Đây là ba cấu hình mô hình để so ngân sách, không phải đổi head ngay trong cùng checkpoint; các số không bao gồm chi phí cấp phát và không chứng minh tốc độ hay chất lượng.
Thực hành tiếp · Quan sát trong lab Transformer
Muốn thấy dữ liệu đi qua toàn bộ hình, mở bài Transformer qua liên kết ở đầu mục Giải pháp rồi chạy lab mặc định trước khi sửa. Lab đó chọn MHA hai head, ba mã token [1, 2, 3] và vector hai số mỗi head, không phải bảng Q/K/V tự chọn phía trên. Dự đoán rồi đối chiếu: mỗi cache K hoặc V có shape (2, 3, 2), đọc là hai head, ba vị trí, hai số; xử lý một token mới thành (2, 4, 2). Ở 2D, hàng đầu của bảng trọng số phải chỉ đọc chính nó; ở 4C, các cột logits lại là token ứng viên. Dùng hướng dẫn và đáp án trong lab để kiểm tra cache với tính lại toàn chuỗi. Bài arch-attention không có cell riêng và ví dụ tính tay không thay cho kết quả chạy lab.
6Thuật ngữ
- Query / Key / Value — Q/K/V
- Ba vector được tạo từ biểu diễn token: Q dùng để đối chiếu với K của các vị trí được phép đọc; V là nội dung đem cộng theo trọng số. Chúng là các danh sách số, không phải câu hỏi và câu trả lời bằng văn bản.
- Attention head — đầu chú ý
- Một nhánh đối chiếu Q với K rồi gom V. Nhiều head cho nhiều phép đối chiếu học được; không mặc định mỗi head chuyên một nhiệm vụ ngôn ngữ cố định.
- Score và attention weight
- Score là điểm đối chiếu Q với K, có thể âm. Attention weight là trọng số sau softmax, không âm và có tổng mỗi hàng bằng 1 trong attention chuẩn của bài này; nó phân bổ thông tin trên vị trí đầu vào.
- Causal mask — mặt nạ nhân quả
- Quy tắc một vị trí chỉ đọc chính nó và các vị trí trước. Đặt điểm tương lai thành âm vô cực trước softmax để trọng số ở đó bằng 0.
- KV cache — bộ nhớ đệm Key/Value
- K/V của token đã xử lý được giữ lại để dùng khi xử lý token tiếp theo. Nó tránh tính lại K/V cũ, nhưng token mới vẫn cần đối chiếu Q mới với các K được phép đọc.
Glossary (9)
- Token và vector biểu diễn
- Token là đơn vị văn bản mà mô hình xử lý, có thể là một phần từ. Mã token dùng để tra vector, tức danh sách số biểu diễn vị trí đó; mã không phải giá trị ngữ nghĩa của từ.
- Tensor và shape
- Tensor là mảng số nhiều chiều; shape ghi số phần tử theo từng trục. Trong ví dụ ba token, một head và vector hai số, bảng K có ba hàng vị trí và hai cột thành phần.
- Tích vô hướng
- Nhân từng cặp phần tử cùng chỉ số của hai vector rồi cộng lại, tạo một số. Ví dụ [1, 0] đối chiếu với [1, 0] cho 1, với [0, 1] cho 0.
- Softmax
- Đổi các điểm thành trọng số: lấy hàm mũ của từng điểm rồi chia cho tổng các hàm mũ trên cùng hàng. Ô bị chặn có điểm âm vô cực nên nhận trọng số 0.
- RoPE — Rotary Position Embedding
- Phép xoay Q/K theo vị trí để điểm đối chiếu mang thông tin khoảng cách tương đối. Trong kiến trúc minh họa, V không xoay; token mới phải dùng vị trí tiếp nối cache.
- Prefill và decode
- Prefill xử lý chuỗi đầu vào ban đầu. Decode tiếp tục xử lý token mới để tạo điểm cho token sau nữa; chọn token từ điểm và đưa token đó qua mạng là hai việc khác nhau.
- Logits
- Các điểm chưa chuẩn hóa trên bảng token ứng viên ở đầu ra cuối mạng. Khác với bảng trọng số attention có cột là vị trí đầu vào.
- Checkpoint và kernel
- Checkpoint lưu các tham số đã học của mô hình. Kernel là hàm tính toán thực hiện một hay nhiều phép toán trên thiết bị; thay kernel tương đương không có nghĩa được đổi cấu trúc Q/K/V của checkpoint.
- Kiểu số và băng thông bộ nhớ
- Kiểu số quyết định cách biểu diễn và số byte mỗi phần tử; ví dụ số dấu phẩy động 16 bit dùng hai byte. Băng thông là lượng dữ liệu có thể đọc/ghi trong một đơn vị thời gian.