Thực hành tiếng nói
Lab tổng hợp · huấn luyện audio bằng NumPy
Chạy ba mục tiêu học trên tone tổng hợp, đọc số thật và phân biệt kiểm tra cơ chế với chất lượng tiếng nói.
1Định nghĩa
Bài lab huấn luyện audio thu nhỏ là một chương trình NumPy tự tạo tín hiệu để tách và quan sát ba bài toán: tái tạo sóng, đoán mã audio và nhận dạng nhãn từ audio.
Bạn dùng kiến thức causal LM và vòng huấn luyện của hai khóa tiên quyết; CE chấm xác suất nhãn đúng, gradient truyền sai số và AdamW sửa tham số. Codec RVQ tạo nhãn cho LM, còn ASR đi từ Mel trực tiếp đến nhãn khung, không nhận đầu ra của LM.
Ví dụ đời thường: ba bàn thực hành dùng chung các mẫu âm: một bàn nén rồi khôi phục, một bàn nhìn chữ giả để chọn mã, một bàn nghe tone để gắn nhãn. Kết quả của mỗi bàn cần cách chấm khác nhau.
2Luồng
Tám khối là thứ tự chương trình toy; các nhánh ASR và codec trên sơ đồ độc lập.
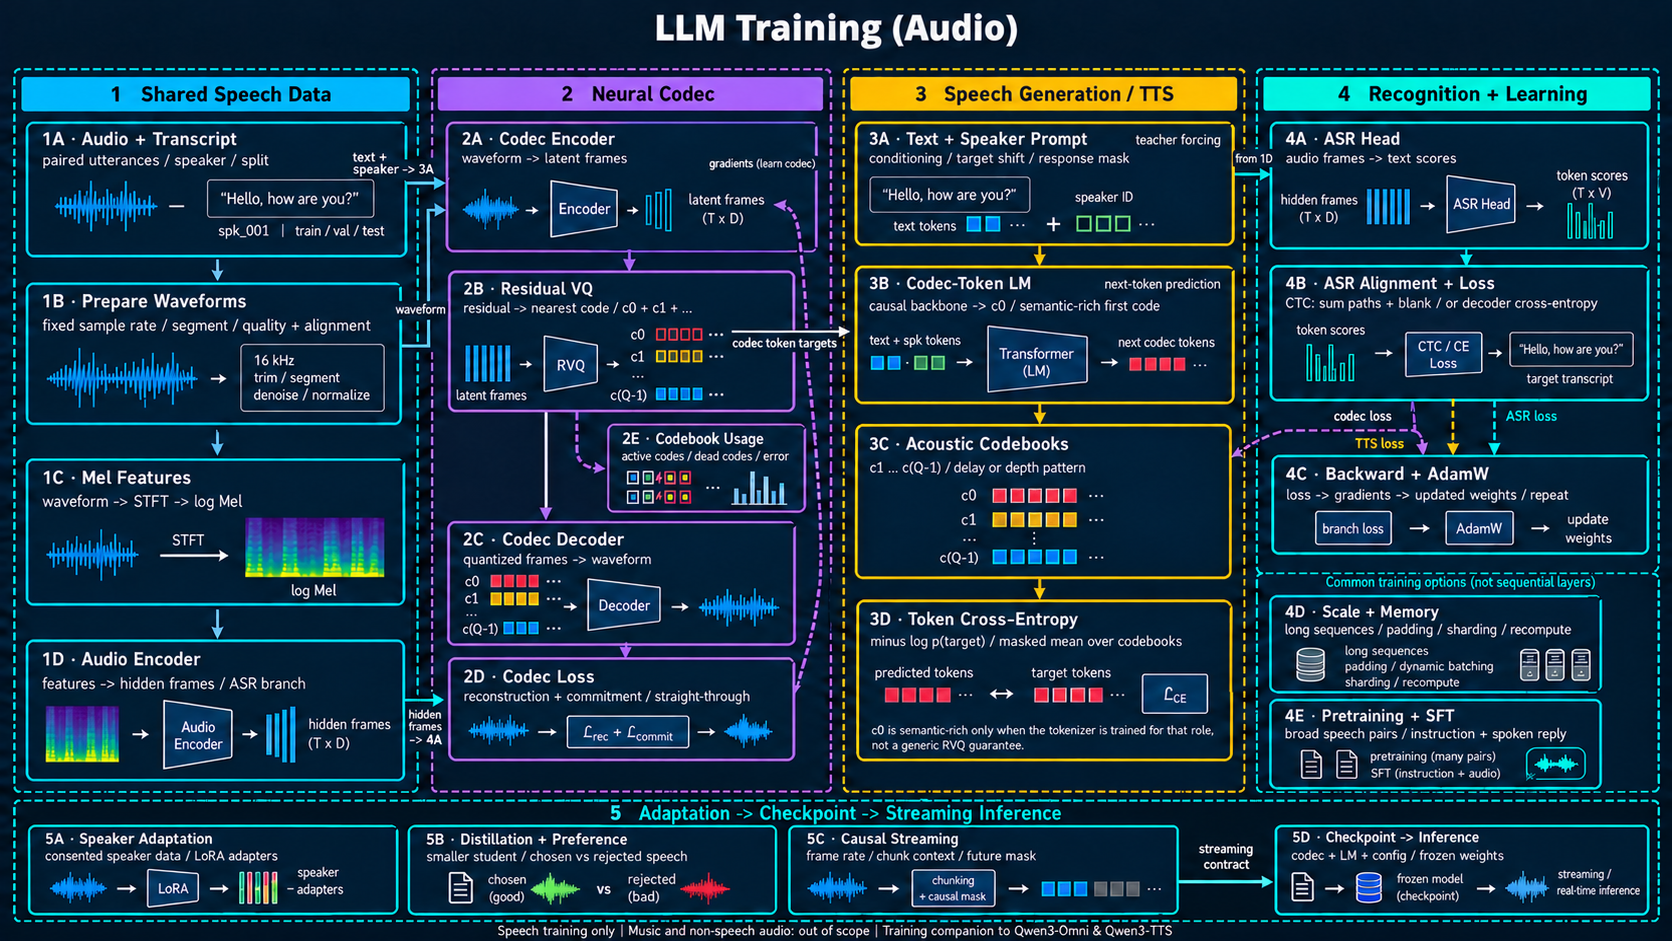
sóng + lời + người nói → manifest đã chia tập1A · Audio và bản chép lời
Chọn cặp tiếng nói và bản chép lời, giữ thông tin người nói và tách tập để đo khả năng khái quát.
- Nhận gì
- Bản ghi tiếng nói, transcript, người nói và nguồn có quyền dùng.
- Làm gì, vì sao
- Ghép đúng đoạn sóng với lời được nói; chia tập theo nguồn/người nói trước khi học để tránh rò dữ liệu.
- Ra gì
- Audio cho codec/ASR, chữ và giọng làm điều kiện cho TTS; không phải một nhãn chung cho ba nhánh.
- Ví dụ, cách đọc ô
- Lab: 192 khung tone có nhãn A/B/C và hai biên độ giả giọng, tách 164 học / 28 kiểm định.
- Lưu ý
- Chia theo khung tone không mô phỏng người nói chưa gặp.
- Tạo và biểu diễn audio
Tạo sóng cùng nhãn, tách tập, lấy năng lượng Mel.
- Học ba bài toán
Codec học sóng; LM học mã; ASR học nhãn khung, với ba loss khác nhau.
- Kiểm giới hạn
Kiểm gradient decoder, không nhìn tương lai và nạp lại codec; ghi phần chưa triển khai.
Mã Mermaid
flowchart TD
  step1["Tạo và biểu diễn audio"]
  step2["Học ba bài toán"]
  step3["Kiểm giới hạn"]
  step1 --> step2
step2 --> step33Giải pháp
Bắt đầu bằng một dự đoán
Viết dự đoán MSE codec sẽ đổi ra sao và CE đoán đều tám mã bằng bao nhiêu. Mở hướng dẫn đầu vào trước khi chạy: nhãn A/B/C chỉ tương ứng ba tần số, speaker giả chỉ là biên độ.
Chạy và đọc bằng chứng
Chạy toàn file rồi đối chiếu tám giai đoạn với sơ đồ. Mỗi khối có Quan sát, Kết luận và Không chứng minh; đọc đủ cả ba trước khi diễn giải PASS.
Thử một thay đổi
Chọn một bài tập ở dưới, sửa đúng một hằng số, ghi lại các con số và trả lời vì sao. Đối chiếu đáp án đã chạy; không biến sự khác nhau trong một seed thành kết luận cho tiếng nói thật.
4Profiling
- Mốc đúng của lần chạy mặc định
Seed 17: 192 khung, 164 học và 28 kiểm định; MSE codec 0.232382 → 0.001859, kiểm định 0.002234; [3,5] mã hoạt động trên tám mã mỗi bảng; CE của LM 2.1214 → 0.0015; CE ASR 0.9248 → 0.0082, accuracy khung 100%; gradient decoder lệch dưới 1e−6, tiền tố và nạp lại codec lệch dưới 1e−12; cuối output là PASS. Chữ số cuối có thể khác theo NumPy.
- Tính so sánh
Giữ seed, dữ liệu, sample rate và cấu trúc cố định khi so một thay đổi. Không đo speedup hoặc chất lượng cảm nhận từ thời gian chạy toy; số bit là tính lý thuyết.
Mẹo đo lường: ghim số liệu trên workload thật, ghi cả p50/p95/p99 thay vì chỉ trung bình, và luôn ghi lại điều kiện chạy (batch, cache, đồng thời, phần cứng) trước và sau khi tối ưu. Số đo thiếu điều kiện chạy thì không so sánh được.
5Ví dụ
Ba mục tiêu không phải một pipeline nối tiếp
Codec dựng lại sóng bằng MSE; LM học ID mã bằng CE; ASR dùng đặc trưng Mel và nhãn khung. ASR không chờ codec hoặc LM, còn mã codec được đóng băng trong khi LM học.
Giới hạn PASS
Giảm LM_STEPS xuống 10 vẫn có PASS nhưng CE còn 1.4325. Dòng PASS chỉ kiểm giảm loss và ngưỡng số; tự kiểm: có thể dùng nó để nói mô hình đọc tiếng Việt tự nhiên không? Không.
6Thuật ngữ
- Tone tổng hợp
- Sóng sin được tạo bằng chương trình; nhãn giả giúp quan sát phép tính, không đại diện tiếng nói thật.
Glossary (1)
- Teacher forcing
- Khi học, vị trí sau nhận mã đúng quá khứ; khi sinh, nhận mã chính mô hình dự đoán.
7Bài liên quan
8Nguồn
9Bài lab
Huấn luyện audio thu nhỏ: codec, LM và ASR
NumPy · tone tổng hợp · tám giai đoạnDự đoán trước khi chạy: codec chưa học có MSE cao hơn hay thấp hơn sau học? Với tám mã, CE đoán đều là ln 8. Chạy toàn file, đọc Quan sát → Kết luận → Không chứng minh ở từng khối. Đổi một hằng số mỗi lần rồi đối chiếu bài tập.
Mục tiêu và kiến thức cần nhớ
Bạn cần đọc được mảng NumPy và đã học causal LM, cross-entropy, gradient và AdamW trong LLM Foundations và LLM Training (Text). Nhắc lại: CE bằng −ln xác suất nhãn đúng; gradient là độ nhạy loss theo tham số; AdamW dùng trung bình gradient và bình phương gradient để sửa tham số.
Sau lab, bạn tách được ba mục tiêu: codec tái tạo waveform, LM dự đoán codec ID có điều kiện, ASR dự đoán nhãn chữ từ đặc trưng. PASS chỉ chứng minh các bất đẳng thức và ngưỡng số trong chương trình.
Đầu vào và cấu hình
Không tải dữ liệu: chương trình tạo 192 khung, mỗi khung 64 mẫu tại 8 kHz. Nhãn A/B/C tương ứng 500/1000/1500 Hz; speaker 0/1 chỉ điều khiển biên độ, thêm pha và nhiễu ngẫu nhiên. Đây là “âm vị” giả để quan sát phép tính, không phải tiếng nói.
Chọn mỗi khung thứ bảy cho kiểm định: 164 khung train và 28 validation; đây không phải split người nói mới. Codec có encoder tuyến tính 64→12, hai codebook tám vector rồi decoder 12→64, tổng 1728 tham số. LM là MLP tanh 608 tham số nhìn điều kiện và một mã trước, không có Transformer. ASR là đầu tuyến tính trên 12 dải Mel.
CODEC_STEPS=400, LM_STEPS=350, ASR_STEPS=200, LR=0.01, BETA=0.1, seed 17. Dùng NumPy với co chỉ số einsum cho các ma trận nhỏ. Chạy trong trình duyệt hoặc /usr/bin/python3 public/labs/llm-training-audio/training-audio-end-to-end.py.
Bản đồ tám khối output
Khối 1 ↔ 1A–1B: sóng và nhãn đã cùng sample rate, ranh giới có sẵn; không thực thi resampling hay lọc chất lượng. Khối 2 ↔ 1C: STFT, bộ lọc Mel và log1p; đầu encoder ngữ cảnh 1D chỉ được thay bằng đặc trưng trực tiếp.
Khối 3 ↔ 2A–2E: encoder học latent, RVQ chọn mã rồi decoder dựng lại sóng; MSE, commitment và mã hoạt động là các chỉ số khác nhau. Khối 4 ↔ 4C: AdamW và kiểm đạo hàm decoder; không kiểm argmin hoặc tuyên bố straight-through là gradient thật.
Khối 5 ↔ 3A–3D: đóng băng codec, dùng nhãn text giả và speaker để dự đoán mã, chấm CE và tự sinh mã để dựng sóng. Khối 6 ↔ 4A–4B: ASR theo khung đã căn nhãn, kèm ví dụ collapse CTC; không huấn luyện CTC tổng đường.
Khối 7 ↔ 4D,5C: kiểm không nhìn tương lai theo khung và tính lý thuyết số mã/bit. Khối 8 ↔ 4E,5A,5B,5D: kiểm nạp lại bản sao codec trong RAM; pretraining lớn, SFT, LoRA, distillation và preference chỉ được giải thích, chưa chạy.
Đọc các con số theo đúng câu hỏi
Ở khối 3, so MSE ban đầu 0.232382 với sau học 0.001859 và kiểm định 0.002234. Các số cùng đơn vị bình phương biên độ sóng; commitment 0.004943 nằm trong không gian latent nên không so lớn nhỏ trực tiếp với MSE. Mã hoạt động [3,5] nghĩa ba và năm mã được dùng ở từng bảng, không phải hai ID của một khung.
Ở khối 5, CE ban đầu 2.1214 gần ln 8 ≈ 2.0794; sau học 0.0015 cho thấy xác suất mã đúng tăng trên dữ liệu đơn giản. CE kiểm định dùng teacher forcing, còn MSE 0.002234 của sóng sinh dùng mã tự dự đoán. Hai phép đo trả lời hai câu hỏi khác nhau.
Ở khối 6, accuracy 100% chỉ trên 28 khung tone kiểm định. Collapse giữ hai A khi có blank xen giữa: gộp lặp trước rồi bỏ blank. Khối 7 tính 125 khung/giây × hai codebook = 250 mã/giây, mỗi mã log2(8)=3 bit nên 750 bit/giây chưa có header; đây không phải băng thông được đo.
Bằng chứng và giới hạn
Các assert kiểm MSE và hai CE giảm, sai lệch gradient decoder <1e−6 và hai sai lệch nhân quả/nạp lại <1e−12. Không kiểm mọi gradient của codec, không đo thời gian, không tổng hợp giọng thật và không thực thi đầy đủ mọi ô sơ đồ.
Mỗi ví dụ TTS chỉ một khung, token trước chỉ nằm trong khung đó; không học thời lượng câu hay dừng câu. ASR có nhãn từng khung, không có decoder văn bản hay CTC forward–backward. Các phần chưa dựng được ghi rõ trong bảng và output, không dùng PASS để suy ra chất lượng Qwen.
Kết quả mong đợiSeed 17: 192 khung, 164 học và 28 kiểm định; MSE codec 0.232382 → 0.001859, kiểm định 0.002234; [3,5] mã hoạt động trên tám mã mỗi bảng; CE của LM 2.1214 → 0.0015; CE ASR 0.9248 → 0.0082, accuracy khung 100%; gradient decoder lệch dưới 1e−6, tiền tố và nạp lại codec lệch dưới 1e−12; cuối output là PASS. Chữ số cuối có thể khác theo NumPy.
Tải training-audio-end-to-end.py ↓
Giảm số bước codec
Đổi CODEC_STEPS từ 400 xuống 60. Dự đoán MSE cuối trước khi chạy; so cả train, validation và mã hoạt động.
Đối chiếu sau khi tự trả lời
Đã chạy seed 17: MSE train 0.023338, validation 0.027875, mã hoạt động vẫn [3,5]. So mặc định 0.001859/0.002234: ít bước giữ sai số cao hơn trong trường hợp này; cùng số mã hoạt động không nghĩa cùng tái tạo. Nhãn codec đổi nên CE LM cũng đổi; không cô lập riêng năng lực LM.
Một codebook
Đổi CODEBOOKS từ 2 xuống 1; giữ các hằng số còn lại. Tính trước số mã và bit mỗi giây rồi chạy.
Đối chiếu sau khi tự trả lời
Đã chạy: 125 mã/giây và 375 bit/giây lý thuyết, bằng một nửa cấu hình hai bảng. MSE train 0.003881, validation 0.004295; bốn mã hoạt động. Thay cấu trúc cũng thay đường lấy số ngẫu nhiên nên đây là so hai cấu hình cụ thể, không bằng chứng Q luôn quyết định chất lượng.
LM học ít bước
Chỉ đổi LM_STEPS từ 350 xuống 10. Codec đã học có đổi không? Đọc CE và sóng sinh.
Đối chiếu sau khi tự trả lời
Đã chạy: codec giữ MSE 0.001859; CE LM còn 1.4325, kiểm định teacher-forced 1.4489 và MSE sóng sinh 0.008533. So mặc định 0.0015 và 0.002234: codec tốt chưa đủ, LM cũng phải dự đoán đúng mã. CE vẫn giảm nên PASS không bảo đảm chất lượng cao.
Thứ tự collapse CTC
Tự tính đường A,A,blank,A rồi so với cách “bỏ blank trước, gộp sau”. Không cần đổi chương trình.
Đối chiếu sau khi tự trả lời
Gộp lặp liền nhau trước: A,blank,A; bỏ blank: A,A. Bỏ blank trước tạo A,A,A rồi gộp thành A, làm mất một nhãn. Lab chỉ minh họa phép collapse, không tính CTC loss.