Giới thiệu khóa học
Inference Engineering: hệ thống phục vụ một LLM từ yêu cầu của người dùng đến chip GPU
Sau khi một mô hình ngôn ngữ lớn (LLM) được huấn luyện, nó chưa trả lời được ai. Cần một hệ thống phục vụ nhận yêu cầu, đổi chữ thành token (mảnh văn bản đã được đổi thành số), xếp lịch, chạy mô hình trên GPU (chip tính toán song song) và gửi từng token về cho người dùng. Suy luận (inference) là việc chạy mô hình đã huấn luyện để sinh văn bản; Inference Engineering là cách thiết kế hệ thống đó để trả lời đủ nhanh, đủ chính xác và với chi phí chấp nhận được.
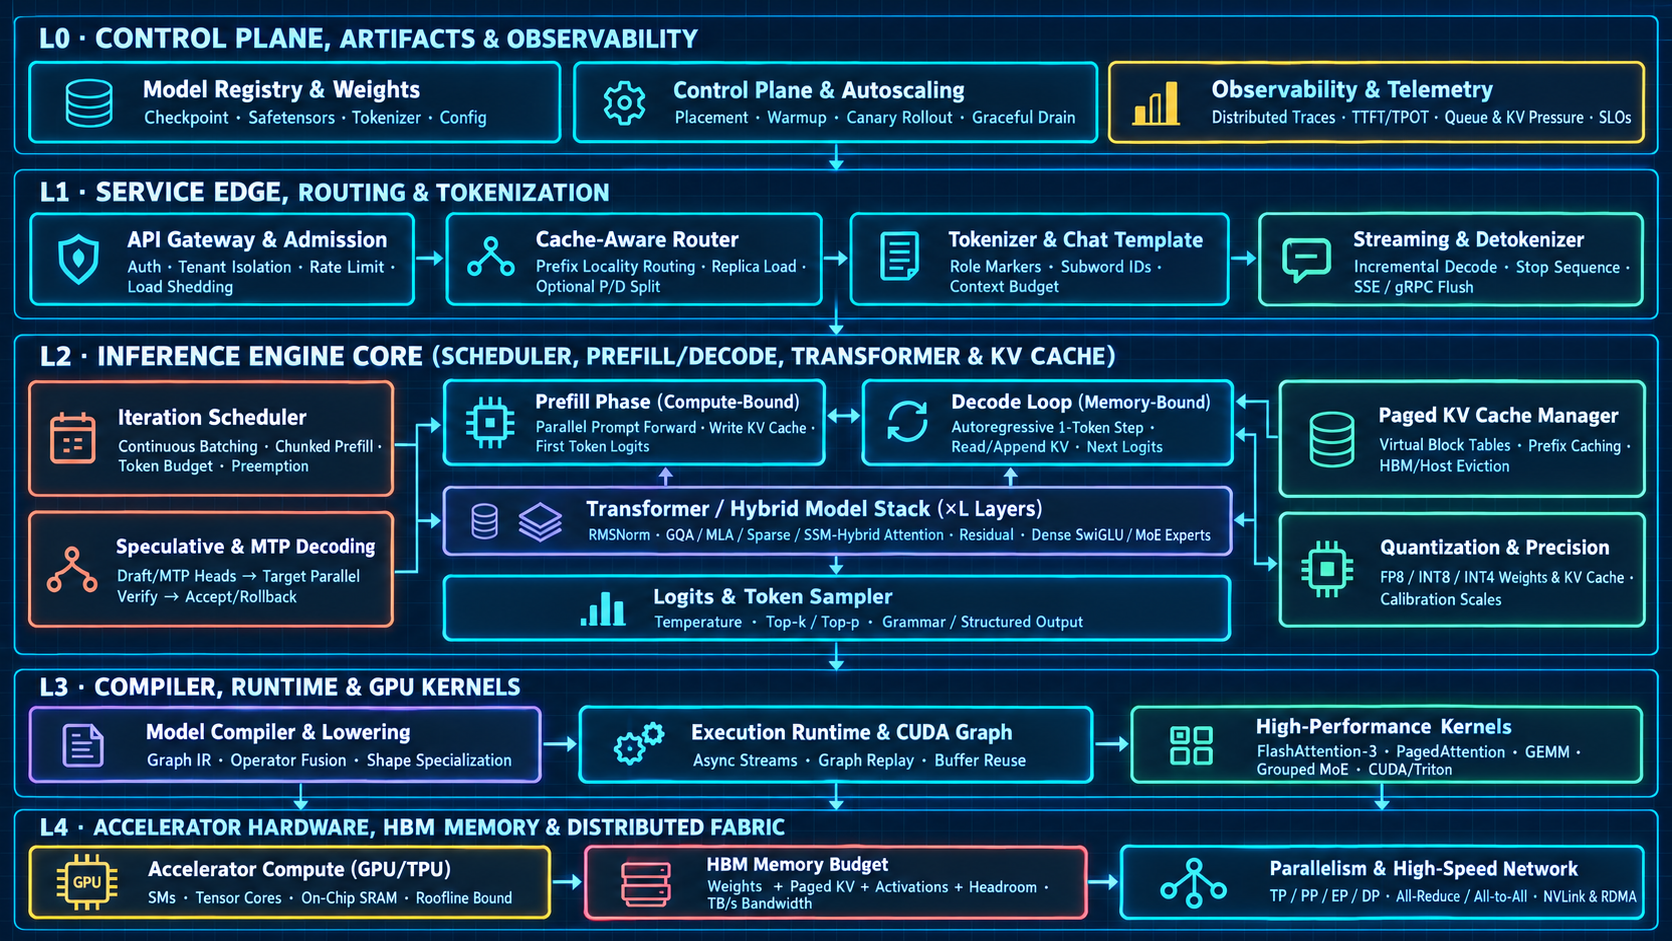
Khóa này dùng một sơ đồ 5 tầng với 21 ô để bạn thấy mỗi quyết định làm đổi hai thước đo chính. TTFT (time to first token) là thời gian từ lúc gửi yêu cầu đến token đầu tiên. TPOT (time per output token) là thời gian trung bình giữa hai token liên tiếp sau token đầu. Bạn cần khóa này để biết vì sao cùng một mô hình có thể nhanh hay chậm, tốn hay rẻ tùy hệ thống bao quanh nó.
Khóa học gồm
- Một sơ đồ 21 ô chia thành 5 tầng
L0đếnL4, từ yêu cầu của người dùng xuống phần cứng; mỗi ô mở một bài học, trong tổng số 33 bài, gồm cả các bài nền tảng hệ thống như lập trình GPU với CUDA, hệ điều hành, lý thuyết hàng đợi, độ chính xác số học và backend. L0điều khiển và quan sát (kho trọng số và phiên bản mô hình, tự thêm bớt bản chạy, tức các bản sao của dịch vụ mô hình, và đo TTFT cùng TPOT) vàL1cổng vào (xác thực và từ chối bớt tải, chọn bản chạy phù hợp, đổi chữ thành token, gửi token về dạng luồng).L2lõi engine: bộ lập lịch, prefill (đọc cả prompt một lượt), decode (sinh từng token), chồng Transformer, bộ chọn token, KV cache (bộ nhớ giữ key và value của các token đã xử lý) và lượng tử hóa (lưu số bằng ít bit hơn).L3biên dịch, runtime và kernel (biến mô hình thành các hàm chạy hiệu quả trên GPU) vàL4phần cứng: GPU, HBM (bộ nhớ băng thông cao gắn trên GPU) và mạng nối nhiều GPU.- Bốn thẻ xuyên suốt dưới sơ đồ: quan sát và chẩn đoán, benchmark và SLO (mục tiêu đo được mà dịch vụ phải đạt, như ngưỡng thời gian trả lời), cổng chất lượng khi đưa bản mới vào chạy, và chi phí cùng dung lượng.
- Tab 02 là một bài lab NumPy theo dõi một yêu cầu qua 13 khối của đường ống phục vụ thu nhỏ.
Học xong, bạn có thể
- Kể đường đi của một yêu cầu: cổng, bộ định tuyến, token hóa, lập lịch, prefill, decode, lấy mẫu, rồi luồng token trả về.
- Giải thích prefill khác decode ở đâu: prefill đọc cả prompt song song và bị giới hạn bởi tốc độ tính (compute-bound), decode sinh từng token và bị giới hạn bởi tốc độ đọc bộ nhớ (memory-bound).
- Nói KV cache là trạng thái của mỗi yêu cầu, tăng theo số token, và vì sao dung lượng HBM là tài nguyên hữu hạn.
- Dùng các nút Trọng tâm TTFT, TPOT, Memory, Scale để chọn nhóm ô cần xem khi gặp triệu chứng: token đầu chậm, các token sau chậm, hết bộ nhớ hay cần thêm GPU.
- Phân biệt các bước nối tiếp với các lựa chọn thay thế hay tùy chọn, và giải thích vì sao phải đo điểm nghẽn trước khi đổi cách thực thi.
Phạm vi: sơ đồ là kiến trúc tham chiếu cho mô hình sinh văn bản kiểu GPT (decoder-only, chỉ nhìn các token trước để sinh token kế tiếp), không vẽ bộ mã hóa riêng cho ảnh hay âm thanh và không đại diện cho hệ thống nội bộ của một hãng cụ thể. Tùy mô hình và engine, một số khối có thể gộp hoặc đổi; khóa dạy suy luận, còn huấn luyện nằm ở LLM Training (Text).
Cách đọc sơ đồ kiến trúc
- Đọc từ trên xuống theo tầng:
L0(điều khiển, quan sát),L1(cổng vào),L2(lõi engine),L3(compiler, runtime, kernel),L4(phần cứng). Mũi tên đi xuống giữa các tầng cho biết tầng trên dựa vào tầng dưới để chạy. Mã ô có dạngL2·3: tầng 2, ô thứ 3. - Ở
L1, mũi tên ngang đi từ trái sang phải:L1·1Gateway,L1·2Router,L1·3Tokenizer đưa yêu cầu vào engine. ÔL1·4Streaming được vẽ cuối hàng nhưng chạy sau cùng: nó nhận token doL2sinh ra rồi gửi về người dùng. L2là vùng đông nhất.L2·1Scheduler (cột trái) chọn việc cho mỗi bước và đưa vàoL2·3Prefill;L2·3vàL2·4Decode nối nhau bằng mũi tên hai chiều và cùng dùngL2·5Transformer; kết quả đi xuốngL2·6Sampler để chọn token.L2·7KV cache vàL2·8Quantization (cột phải) là nơi các ô giữa đọc và ghi trạng thái.L2·2Speculative là lựa chọn thêm để đoán nháp nhiều token.- Ở
L3vàL4, theo mũi tên ngang:L3·1Compiler,L3·2Runtime,L3·3Kernels; rồi các mũi tên đi xuống từL3sangL4, nơi mũi tên ngang nốiL4·1GPU,L4·2HBM vàL4·3Parallelism và mạng. Đây là cách phép tính củaL2thật sự chạy trên chip. - Dải
L0trên cùng không nằm trên đường đi của từng token: nó quản lý trọng số (L0·1), số bản chạy (L0·2) và đo đạc (L0·3) cho cả hệ thống. - Di chuột, hoặc nhấn Tab, lên một ô để đọc pop-over mô tả ngắn; bấm ô hoặc tiêu đề trong pop-over để mở bài học. Nút Trọng tâm làm sáng nhóm ô liên quan tới TTFT, TPOT, Memory hay Scale. Tắt overlay (cạnh Vừa khung) ẩn các khung ô và pop-over để đọc ảnh gốc, bấm lại để bật.
Ô cùng hàng không phải lúc nào cũng nối tiếp nhau: L2·5 Transformer được cả Prefill và Decode dùng. Dưới sơ đồ còn phần Topology khác, tách prefill và decode thành hai cụm riêng.
Core owners · chịu trách nhiệm đường thực thi
Allied owners · chất lượng và vận hành
Tối ưu GPT-style model: đi từ mục tiêu tới bottleneck
TTFT → queue, prefill, cache reuse. TPOT → decode, KV bandwidth, launch overhead. Memory → weights, KV, workspace. Scale → partition, communication và placement. Các nút trên sơ đồ tô sáng những thành phần liên quan.
Topology khác: tách prefill / decode
Router → prefill pool → KV transfer → decode pool. Scale hai pha độc lập, nhưng phải tính network cost và state management. Xem cơ chế P/D split ↗
Nguồn công khai & phạm vi kiến trúc
Framework tổng hợp cơ chế từ tài liệu dưới đây. Hình thể hiện quan hệ chức năng, không khẳng định một implementation duy nhất. Các tối ưu là lựa chọn cần benchmark theo workload.
Danh sách bài học (33)
- Cổng tiếp nhận và kiểm soát yêu cầu
- Chọn bản sao mô hình để xử lý yêu cầu
- Chuyển văn bản thành đơn vị mà mô hình hiểu
- Lập lịch tính toán theo từng bước sinh token
- Xử lý prompt trước khi bắt đầu sinh câu trả lời
- Sinh câu trả lời theo vòng lặp token
- Chọn token từ điểm số và xuất văn bản
- Bộ nhớ đệm key và value của attention
- Đề xuất token trước, rồi để mô hình chính xác minh
- Mô hình transformer biến token thành dự đoán như thế nào
- Tầng thực thi nối bộ điều phối với thiết bị tính toán
- Trình biên dịch tối ưu mô hình cho thiết bị đích
- Các hàm tính toán hiệu năng cao trên thiết bị
- Dùng ít bit hơn để lưu và tính các giá trị của mô hình
- Phần tính toán của accelerator và giới hạn hiệu năng
- Lập ngân sách bộ nhớ trên accelerator
- Chia mô hình hoặc công việc trên nhiều thiết bị
- Trao đổi dữ liệu giữa các worker
- Tách máy xử lý prompt khỏi máy sinh token
- Quản lý vòng đời các bản sao mô hình
- Checkpoint, artifact và việc nạp mô hình
- Theo dõi và tìm nguyên nhân request chậm
- Thiết kế phép đo để so giải pháp công bằng
- Tính chi phí trên công việc thực sự hữu ích
- Kiểm tra tính đúng và chất lượng sau tối ưu
- Cô lập người dùng và quản lý dữ liệu trong cache
- Giữ dịch vụ ổn định khi tải tăng hoặc worker lỗi
- Biến một ý tưởng tối ưu thành kết quả kiểm chứng được
- Viết kernel với tư duy dữ liệu và tính toán song song
- Concurrency, hàng đợi và vòng đời dữ liệu ở host
- Vì sao hàng đợi tăng mạnh khi gần hết capacity
- Hiểu precision và sai số trong phép tính
- Đưa operator của mô hình lên accelerator mới